내 기기에서 쓸 LFM3 고르기, 모델 파일과 실행 메모리는 얼마나 들까
텍스트 모델은 4비트로 줄이면 약 1GB다. 긴 입력을 처리하는 데에는 별도 메모리가 들고, 시각 모델은 학습시킨 작업에 따라 성적이 크게 갈렸다.
스마트폰이나 노트북에 LFM3를 설치하려면 먼저 맡길 일을 정해야 한다. 문서를 읽힐 때 받는 파일과 사진 속 물체를 찾을 때 받는 파일이 다르다. 리퀴드AI가 10월 27일 공개한 여섯 모델은 같은 기반에서 파생됐다. 기기에 필요한 메모리를 따질 때는 모델 파일의 크기와 긴 입력을 읽는 동안 쌓이는 캐시를 따로 봐야 한다.
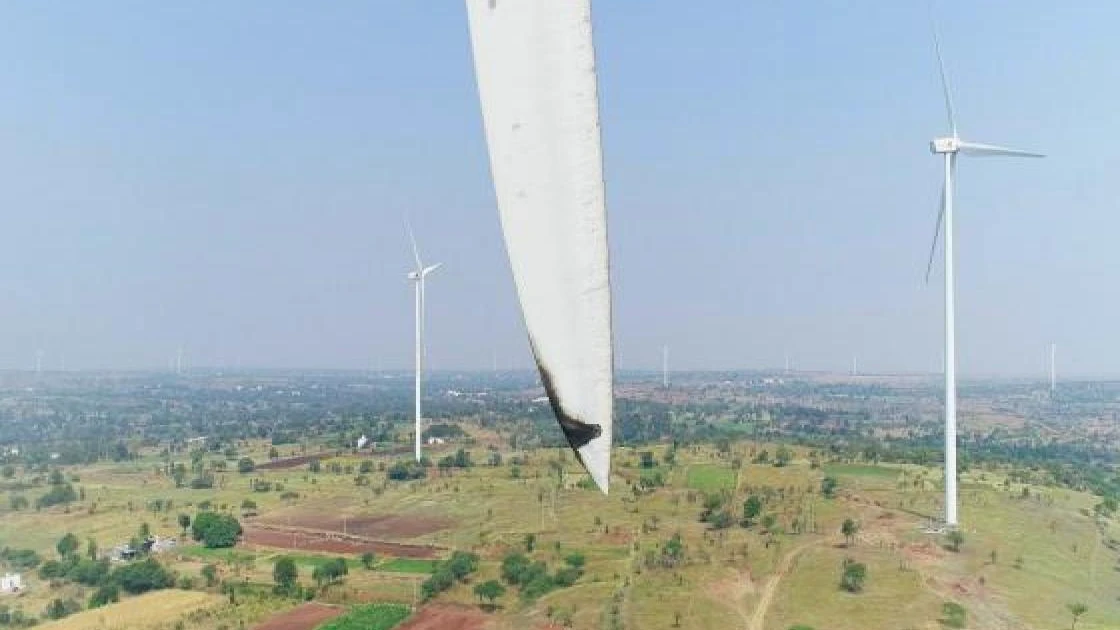
사진 가운데 흰 날개 끝에 붙은 검은 얼룩은 WTBs2025 자료에서 누유로 분류한 곳이다. 리퀴드AI가 공개한 예시에서 추가 학습한 LFM3-VL-2B는 얼룩의 위치와 종류를 모두 맞혔다. 비교 모델 GPT-6 루나도 거의 같은 자리에 사각형을 그렸지만 ‘국부 손상’으로 분류해 정답을 놓쳤다. 모델이 비슷한 곳을 가리킨다는 사실만으로 점검 결과까지 같아지지는 않는다.
여섯 모델 가운데 무엇을 내려받나
| 입력·용도 | 모델명 |
|---|---|
| 텍스트 | LFM3-1.7B |
| 오디오 | LFM3-Audio-2B |
| 시각 | LFM3-VL-2B |
| 시각·음성 통합 | LFM3-Omni-2B |
| 시각 모델에서 파생한 판정 모델 | d1-2B |
| 통합 모델에서 파생한 판정 모델 | d1-Omni-2B |
계보의 출발점은 매개변수 17억 개의 기반 모델 LFM3-1.7B-Base다. 여기서 텍스트, 시각, 오디오, 시각·음성 통합 모델이 갈라진다. 여기에 시각 모델을 추가 학습한 d1-2B와 통합 모델에서 파생한 d1-Omni-2B가 더해진다. 문서를 읽어 글로 답할지, 사진 속 물체를 짚을지, 소리를 듣고 말로 답할지에 따라 내려받을 모델이 달라진다.
예를 들어 글과 사진을 함께 건네 “이 청구서의 날짜는 언제인가, 지정한 항목은 모두 있는가”를 묻는 데에는 d1-2B를 쓸 수 있다. 개발자가 답의 형식을 미리 정해 두면 날짜와 숫자를 읽은 위치, 찾지 못한 항목, 선택지별 확률을 받을 수 있다. 질문들을 하나씩 대화창에 입력하는 대신, 같은 청구서에 대한 여러 항목을 한 번에 계산하는 방식이다. 전화 통화나 음성 메모를 같은 절차에 넣으려면 소리도 받는 d1-Omni-2B가 필요하다.
사람이 말로 질문하고 주변 장면을 함께 보여 주는 서비스에는 LFM3-Omni-2B가 맞는다. 이 모델은 동영상의 프레임과 같은 시점의 소리를 함께 읽고 글이나 음성으로 응답한다. 화면의 어느 버튼인지를 눈으로 보고 말로 지시하는 조합이 가능하다. 오디오만 다루는 LFM3-Audio-2B도 따로 있다. 리퀴드AI는 이 모델에 18개 언어의 음성 인식·합성·번역을 지원한다고 설명한다.
파일은 약 1GB, 긴 대화의 기억은 별도
| 모델 | KV 캐시 |
|---|---|
| LFM3-1.7B | 1.6GB |
| Qwen3.5-4B | 4.3GB |
| MiniCPM5-2B | 5.6GB |
128K토큰 길이의 문맥에서 LFM3-1.7B의 KV 캐시는 1.6GB였다. 회사가 같은 길이로 비교한 Qwen3.5-4B는 4.3GB, MiniCPM5-2B는 5.6GB였다. 이 캐시는 모델이 앞부분을 읽으며 계산한 값을 보관해 다음 말을 만들어 낼 때 꺼내 쓰는 메모리다. 리퀴드AI가 별도로 소개한 ‘약 1GB’는 텍스트 모델 가중치를 4비트 정밀도로 줄였을 때의 크기다. 긴 문서를 열어 놓고 대화를 이어가는 동안에는 그 가중치에 캐시와 프로그램을 위한 공간이 더해진다.
텍스트 모델 카드에 적힌 최대 문맥 길이는 262,144토큰이다. 사용자가 넣은 내용과 모델이 이어서 만들어 낼 답변을 합친 한도다. 한국어도 텍스트 지원 언어 16개에 포함됐다. 로컬 추론 프로그램인 llama.cpp나 Ollama에서는 GGUF 형식의 모델 파일을 사용할 수 있다. 가중치를 내려받아 실행하는 것과 회사가 제공하는 웹 플레이그라운드나 API로 호출하는 것은 별도 경로다. 민감한 문서를 기기 안에서 처리하려는 개발자라면 실제 앱이 어느 경로를 쓰는지부터 구분해야 한다.
같은 모델도 어느 기기에서 얼마만큼의 입력을 처리했는지에 따라 체감 속도가 달라진다. 리퀴드AI는 라이젠 AI 맥스+ 395를 쓴 PC, 애플 M5 맥스, 아이폰 17 프로에서 다른 소형 모델과 비교했다. 이때는 4비트 파일을 llama.cpp에서 실행하고, 문맥을 32,768토큰으로 맞춘 뒤 한 요청에서 100토큰을 생성했다. 회사가 공개한 생성 속도 우위는 이 조건의 결과다. 최대 문맥 사양과 속도 시험에 실제로 쓴 길이 사이에는 여덟 배 차이가 난다. 회사도 이 텍스트 모델을 도구 호출과 정형 응답에 권하고, 자율 코딩이나 복잡한 다단계 추론에는 권하지 않는다고 밝혔다.
낙뢰 자국 두 곳을 짚었다…전체 검사 성적은 달랐다
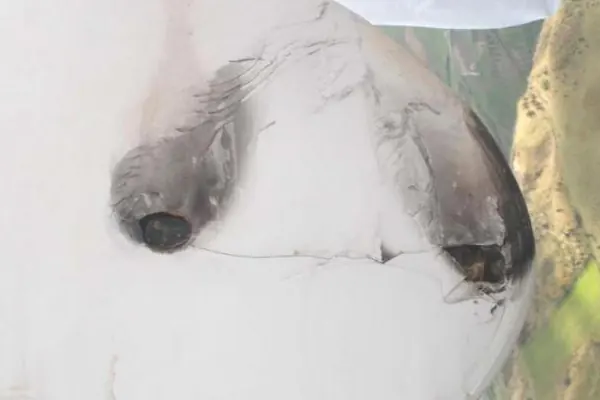
사진의 검은 자국 두 곳은 WTBs2025 원자료에서 각각 낙뢰 흔적으로 표시한 부분이다. 공개한 평가 예시에서 추가 학습한 LFM3-VL-2B는 두 곳 모두 사각형의 위치와 손상 종류를 맞혔다. GPT-6 루나는 같은 사진에 ‘도장 균열’과 ‘국부 손상’이라는 상자들을 내놓아 두 곳 모두 채점 기준을 통과하지 못했다.
연구팀은 풍력 발전기 날개의 표면 결함 아홉 종류를 구별하는 데 시각 모델을 맞춰 봤다. 공개 사진 약 3천 장으로 엔비디아 A100 한 장에서 추가 학습했고, 훈련에서 빼 둔 1,372장으로 채점했다. 일부 사진에는 같은 원본에서 밝기나 방향 등을 바꾼 사본도 있었다. 같은 사진이나 같은 묶음에서 파생한 사본이 학습용과 평가용에 양쪽으로 들어가지 않도록 데이터를 나눴다.
사진을 대표하는 결함 종류를 맞힌 비율은 추가 학습 전 9.2%에서 66.5%로 올랐다. 모든 손상 지점을 찾아야 하는 검사는 문턱이 더 높다. 모델이 그린 상자와 정답 상자가 겹치는 면적을 두 상자의 합집합 면적으로 나눠 0.5 이상이어야 하고, 종류도 맞아야 했다. 이 기준에서 추가 학습 모델이 맞힌 결함은 정답 2,030개 가운데 190개였다. 놓친 곳과 잘못 표시한 곳을 함께 반영하는 탐지 F1 점수는 0.106이었다.
모델을 현장에 쓰려는 사람이 묻는 “정상인 날개에도 정비 경고를 얼마나 자주 띄울까”라는 질문은 이 시험으로 풀리지 않는다. 평가에 쓴 자료에는 결함이 있는 날개만 들어 있다. 리퀴드AI는 코드와 평가 기준, 모델 가중치를 공개했다. 실제 배치 전에 필요한 것은 자신의 카메라와 촬영 거리로 모은 자료, 그중에서도 이 데이터셋에 빠진 정상 사례를 포함한 별도 점검이다.